9月17日,医学人工智能测评验证联合实验室(以下简称“联合实验室”)在人工智能促进健康全球倡议2026年会(GI-AI4H)上发布年度系列成果,包括MedAIBench测评验证体系2.0、15大专科专病测评体系、多模态测评共建计划和公开高质量测评集。
联合实验室由国家人工智能应用中试基地(医疗)·浙江联合中国信息通信研究院、中国医学科学院北京协和医学院于2025年共同成立,旨在构建"平台测评+临床验证"的医学人工智能产品验证体系。
联合实验室打造的MedAIBench测评体系重点强调要在动态化、过程化、真实临床场景下进行测评。2.0版本进一步加大测评难度,丰富了复杂场景中的推理能力的测评维度,更全面考察模型在真实医疗场景中的信息处理、推理质量和结果可靠性。不仅关注能否给出正确答案,更检验其在真实诊疗链条中的实际可用性。
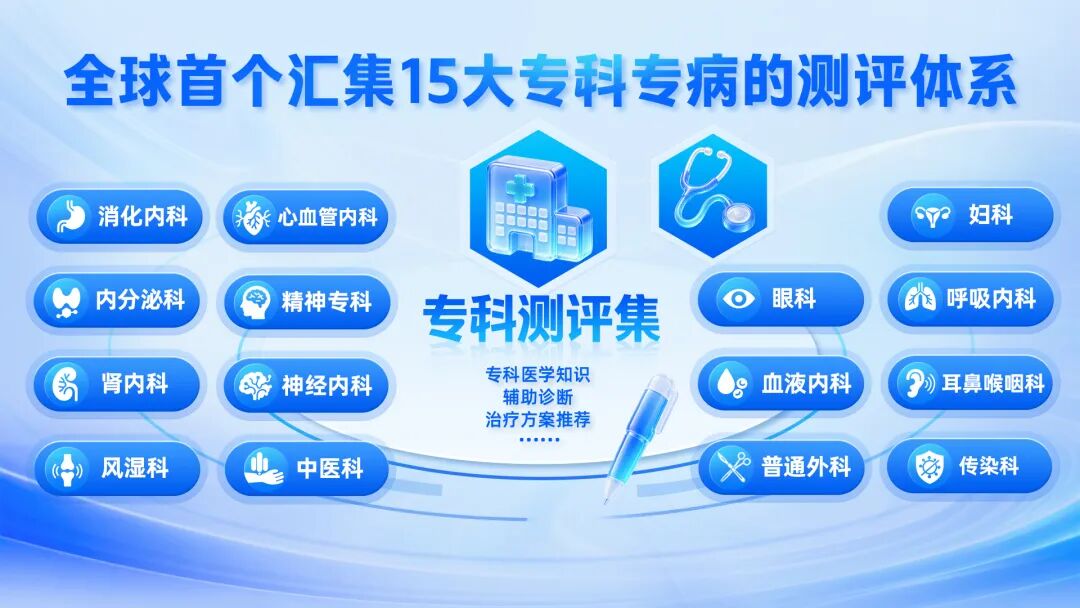
此次还发布了15大专科测评体系,首批成果覆盖心血管内科、消化内科、精神专科、中医科、内分泌科、肾内科、风湿科、神经内科、眼科、血液内科、普通外科、耳鼻咽喉科、传染科、妇科、呼吸内科等15个专科。题目覆盖诊前、诊中、诊后全链条,构建涵盖信息采集质量、核心决策能力等多维度的可量化指标矩阵,力求贴近真实诊疗逻辑,为临床专科AI应用提供可验证、可比较的验证标尺。
多模态测评共建计划主要聚焦CT、X线/DR、MRI、超声、病理、眼底等六大核心模态,邀请具备相应能力的医疗机构、科研院所、科技企业加入共建计划,围绕测评标准、测评场景、测评数据集,打造"多模融合,全链贯通"的测评体系。
此外,联合实验室还面向行业公开了部分高质量测评题目,涵盖医疗知识问答、医疗安全伦理等核心维度,供科研机构、企业和开发者用于模型能力自测与技术研究,降低行业测评门槛。
公开链接:
arXiv: https://arxiv.org/abs/2601.06193
github:https://github.com/yarkcy/MLB
申请地址:
https://www.medaibench.cn/opendatasets
免责声明:
智慧医疗网转载其他网站内容,出于传递更多信息而非盈利之目的,内容仅供参考。版权归原作者所有,若有侵权,请联系我们删除。
本平台所发布信息的内容和准确性由提供消息的原单位或组织独立承担完全责任!
凡来源注明智慧医疗网的内容为智慧医疗网原创,转载需获授权。